一个模型知道得更多,是否就意味着它在每一道科学问题上都更可靠?一个参数量更小的模型,又能不能把自己的专长传给更大的模型?
科学推理中的能力差异,往往藏在具体环节里。模型可能列对公式,却解释错物理机制;也可能算对中间步骤,却在最后的证据判断上失误。ScienceRSI 把这些局部差异转化为模型之间相互学习的机会。
这项工作由 Scinetics 与复旦大学、中国科学技术大学、香港科技大学的研究者共同完成,围绕专业化、验证、迁移与复用组织科学模型训练。
01 科学能力需要在模型之间积累
训练一个擅长计算的模型、一个擅长机制分析的模型,并不自动意味着我们得到了一位能力更全面的科学助手。各个模型的优势可能互补,也可能把各自的错误一起带入新的模型。
ScienceRSI 回答一个更细的问题:面对当前模型的某个具体失误,哪位专家确实能提供更好的判断?只有当专家在同一项科学要求上优于当前回答时,它的贡献才会被采用。
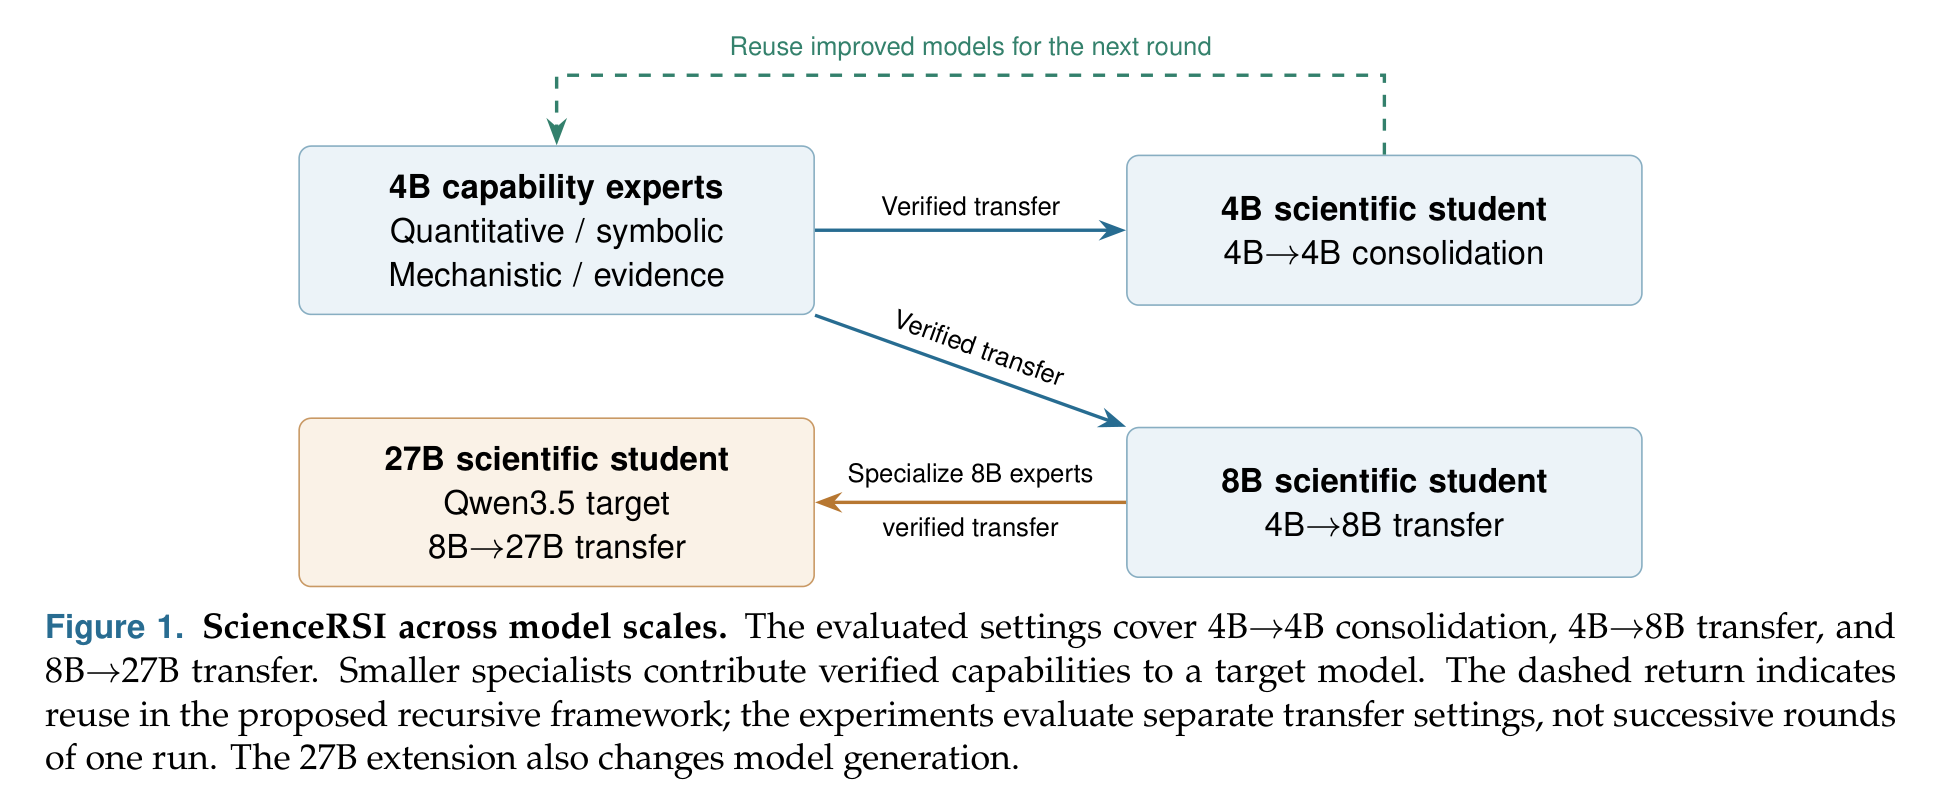
专业化。培养分别侧重定量计算、符号推导、机制解释和证据判断的紧凑专家模型。
验证。把科学回答拆成可检查要求,判断专家是否确实在相应要求上更好。
迁移。让经过筛选的专家反馈对应到目标模型真正需要改进的部分。
复用。将改进后的模型作为进一步专业化和后续循环的起点。
02 4B 与 8B 模型在五项科学评测中领先
报告选用七项基准,覆盖科学推理、领域科学与通用推理。在 4B 与 8B 两组实验中,ScienceRSI 在五项科学基准上的得分均位居所比较方法的首位。
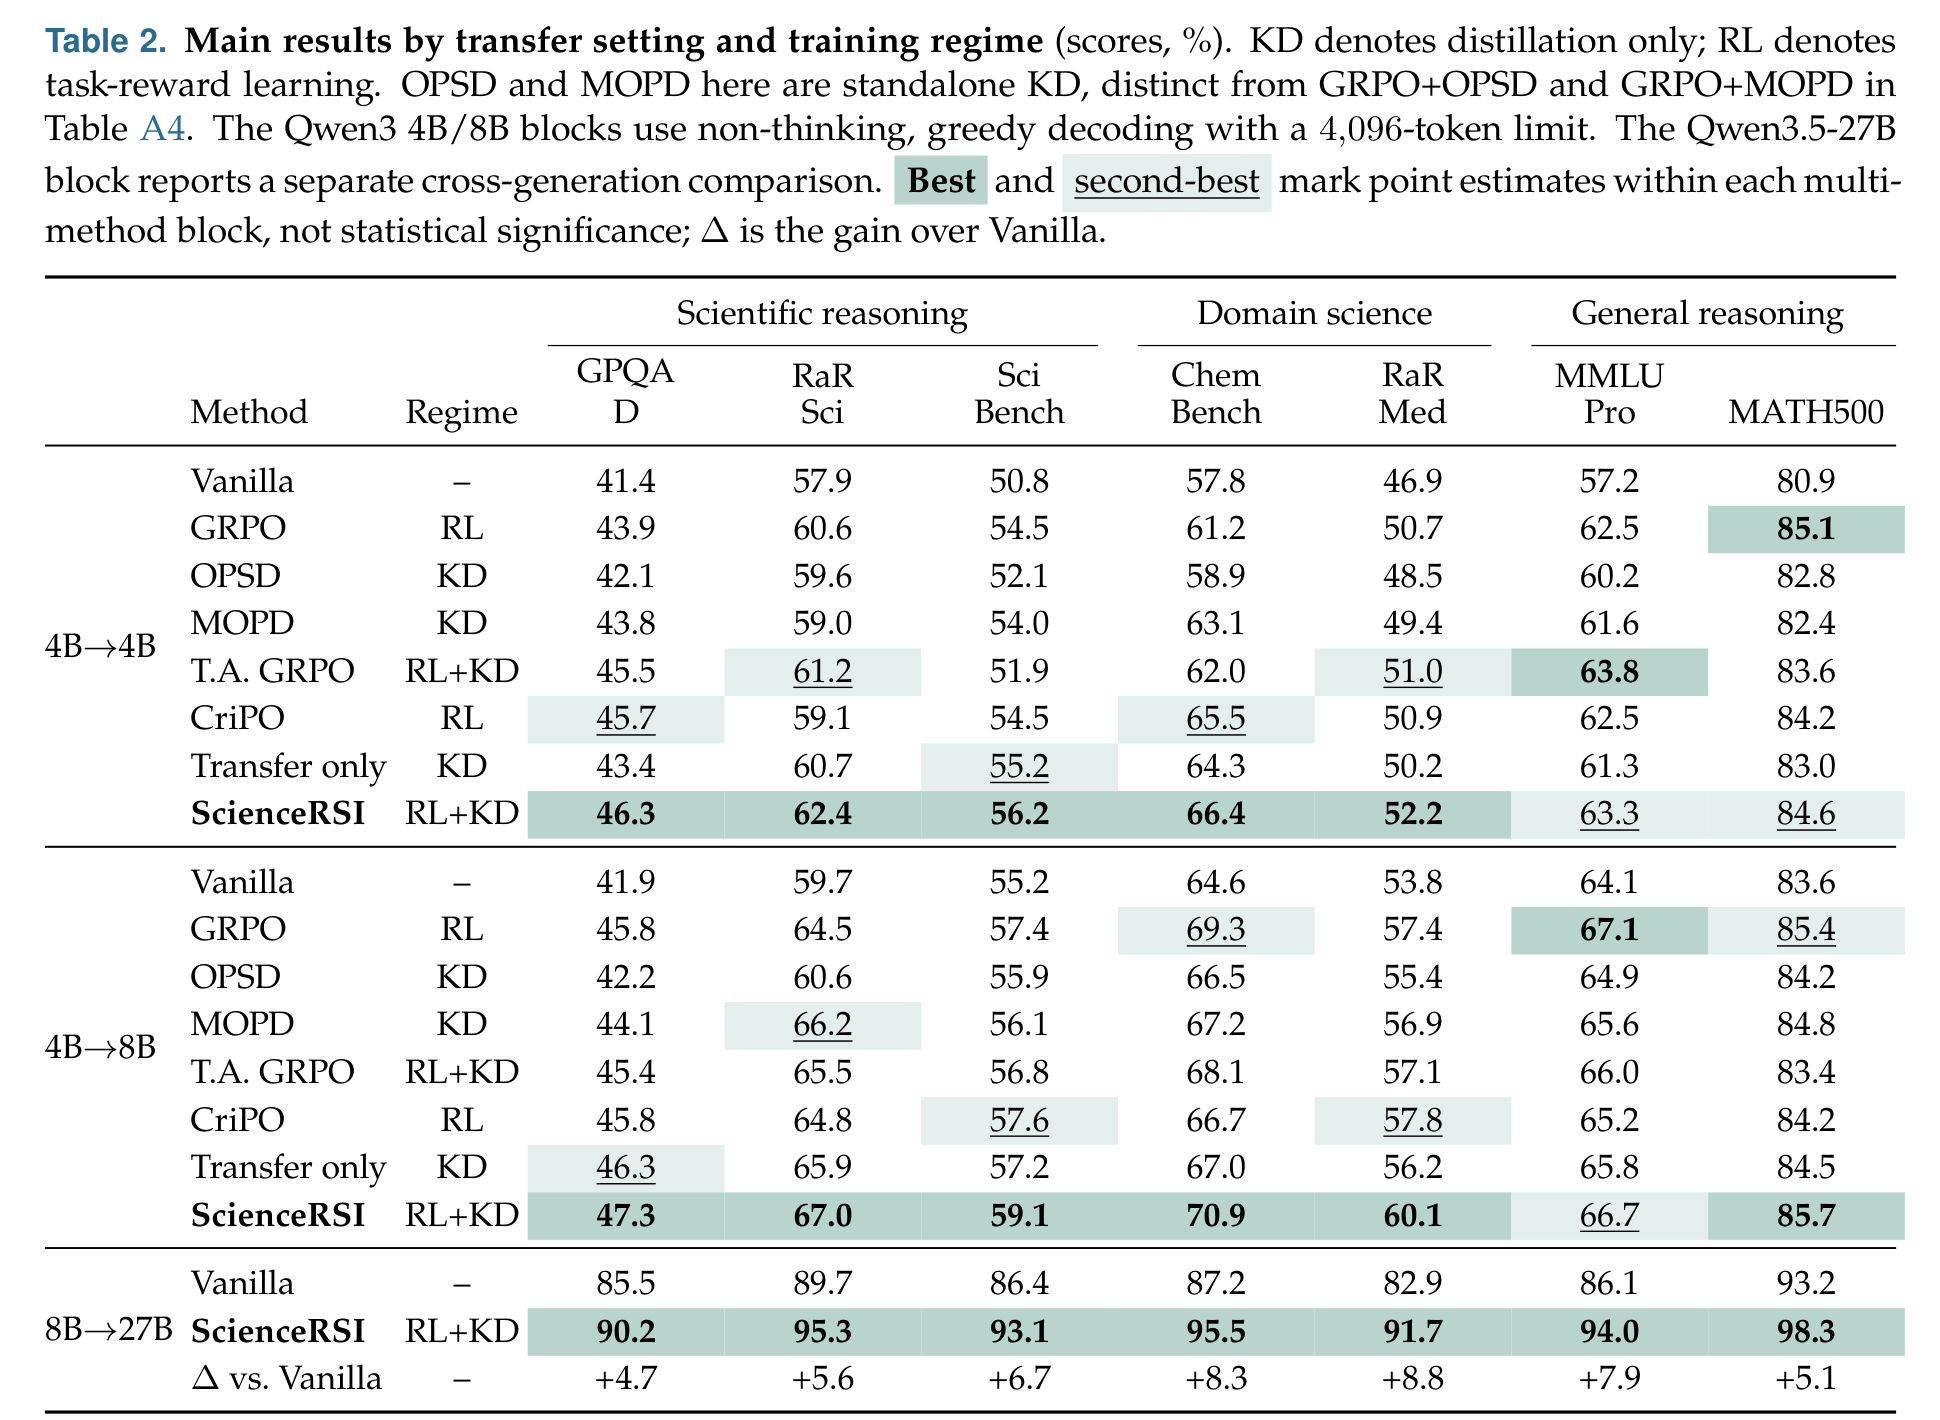
在 4B→4B 设置中,科学推理平均分达到 55.0%,比 GRPO 高 2.0 个百分点。在 4B→8B 设置中,科学推理与领域科学平均分分别提高 1.9 和 2.1 个百分点,同时在 MATH500 上达到 85.7%。
03 较小专家也能改进更强的 27B 模型
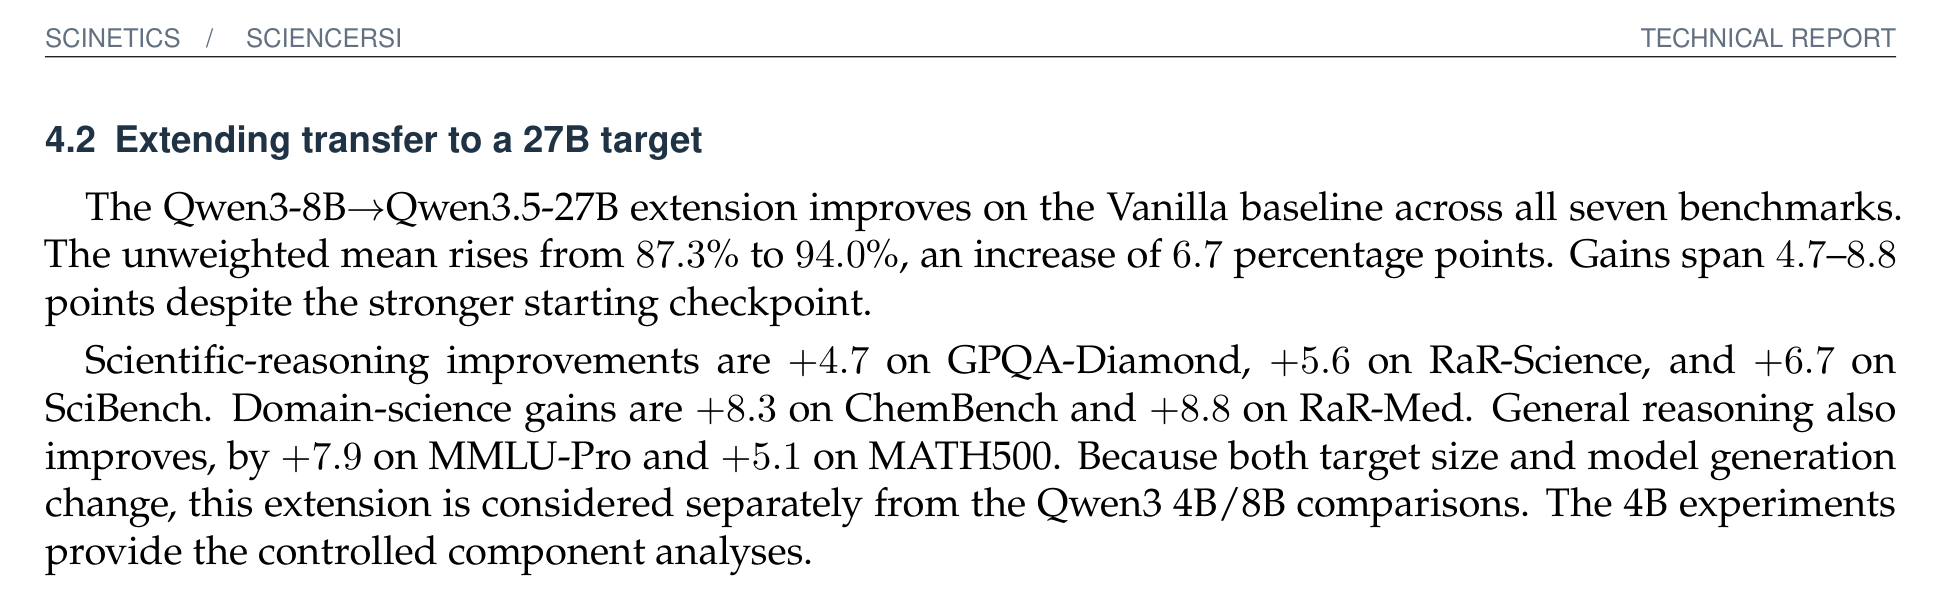
团队使用 Qwen3-8B 专家向 Qwen3.5-27B 目标模型迁移科学能力。相较于对应的 Vanilla 起始模型,ScienceRSI 在七项基准上均取得更高得分,等权平均分从 87.3% 升至 94.0%,各项增幅为 4.7 至 8.8 个百分点。
04 专家反馈需要经过筛选才能发挥作用
把多个专家的输出全部交给学生模型,并不保证提升。在同一 4B 学生模型上,GRPO 的科学推理平均分为 53.0%,GRPO+MOPD 为 50.1%,ScienceRSI 达到 55.0%。
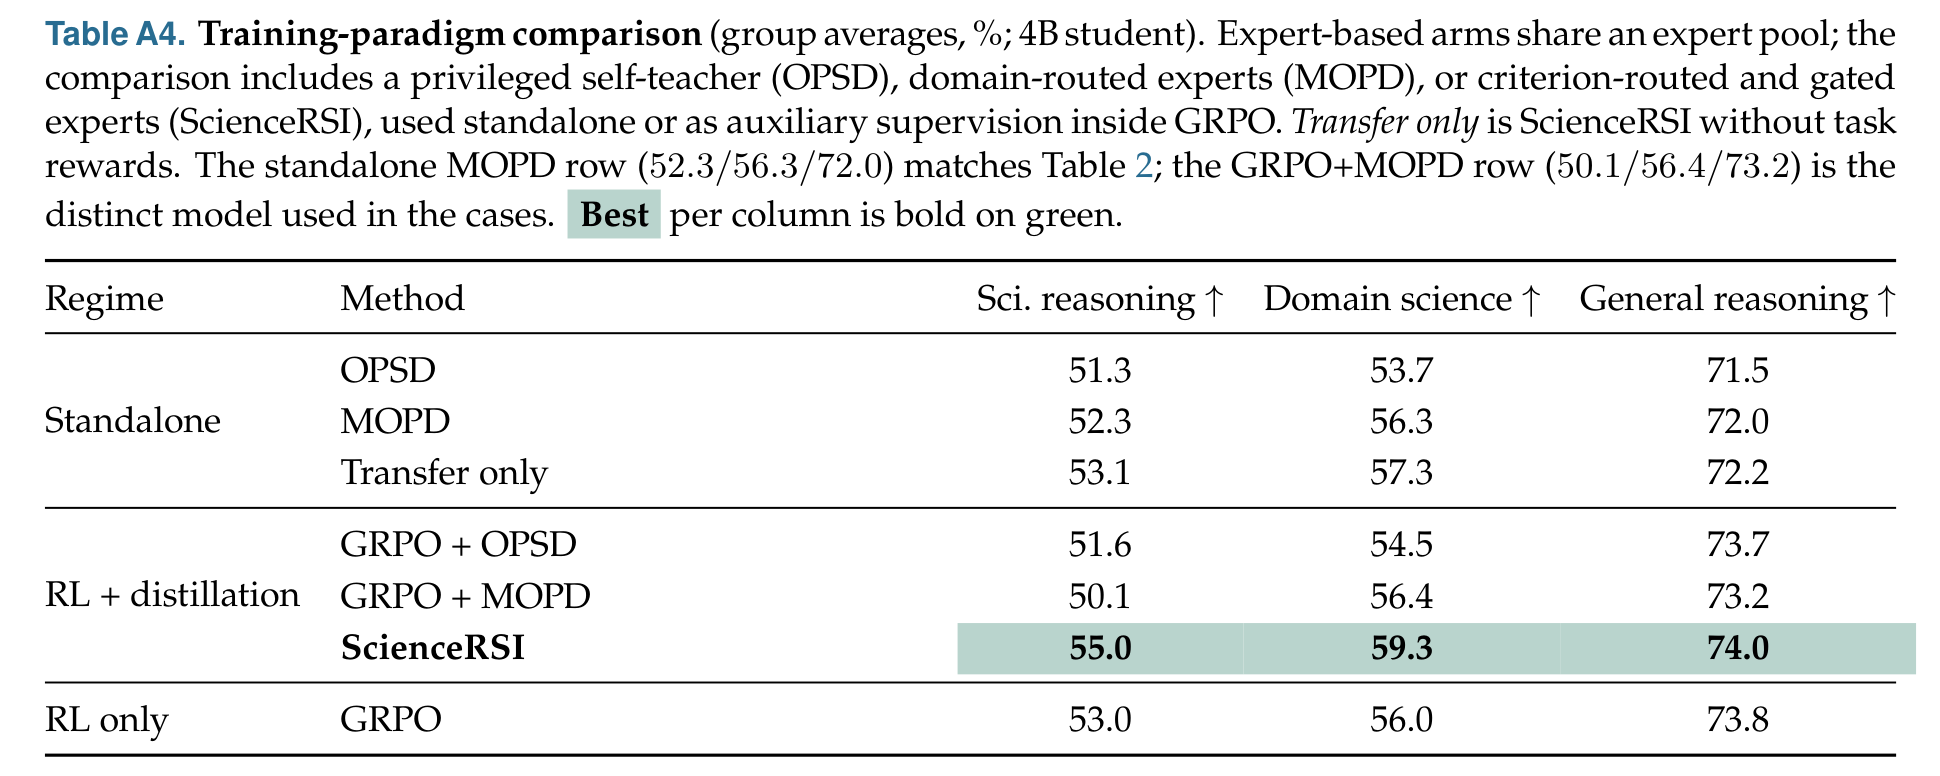
去掉专家贡献验证后,科学推理平均分从 55.0% 降至 50.6%;保留相同监督覆盖量、但随机移动反馈位置后,科学推理与领域科学平均分分别下降 6.3 和 12.1 个百分点。训练信号的价值取决于它是否对应真实能力缺口。
05 迈向递归式科学自我改进
本次报告验证了不同规模下的能力迁移,并未证明连续多轮递归一定能够持续积累收益。随着目标模型变强,专业化训练、任务难度与验证能力也需要同步提升。
ScienceRSI 提供了一个经过实验检验的起点:科学能力可以被专业化、验证、迁移和复用,而不必停留在彼此孤立的模型中。
研究与模型