大模型用文字展开思维链。科学家却经常在另一种“语言”里思考:挪动一个原子、比较两种蛋白质构象,或从实验曲线中判断一个假设是否站得住脚。
这就是我们提出的 Chain of Science Tokens——科学 Token 链。它让文字与科学对象共同参与推理:语言提出目标,结构与数据承载中间步骤,每一步产生的科学状态,都成为下一步决策的依据。
我们是 Scinetics 团队,致力于探索 AI for Science(AI4S)的基础模型与科学智能体。在 Perspective 《Scientific Super Intelligence: From Science Tokens to ScienceRSI》↗中,我们把这条研究路线归纳为四个相互连接的问题。
这条路线从 Science Tokens 出发,让科学对象成为可读写的推理单元;以科学超级智能为能力目标,再通过 ScienceRSI,把有证据支持的任务经验用于训练下一代模型。验证后的成果则沉淀为科学资产,供模型与实验室持续复用。
这篇文章先展开这张路线图,再回到一个具体起点:我们近期的 Chain of Structures 工作,如何把科学空间推理带入酶设计。
01 让科学对象进入推理过程
对模型而言,Token 是处理信息的基本单元。Science Tokens 把这一接口延伸到科学对象:蛋白质或核酸序列、局部三维几何、显微图像、组学状态,以及带单位和实验条件的测量值,都可以采用适合各自特点的表示,与语言在同一模型中交互。
重点是让这些表示保留科学含义。一个数值需要单位,一次测量需要条件,一个结构需要说明它来自预测还是实验。不同模态也可以保留不同表示方式:序列使用天然离散符号,几何使用可解码的结构编码或连续表示,测量值携带类型与来源。
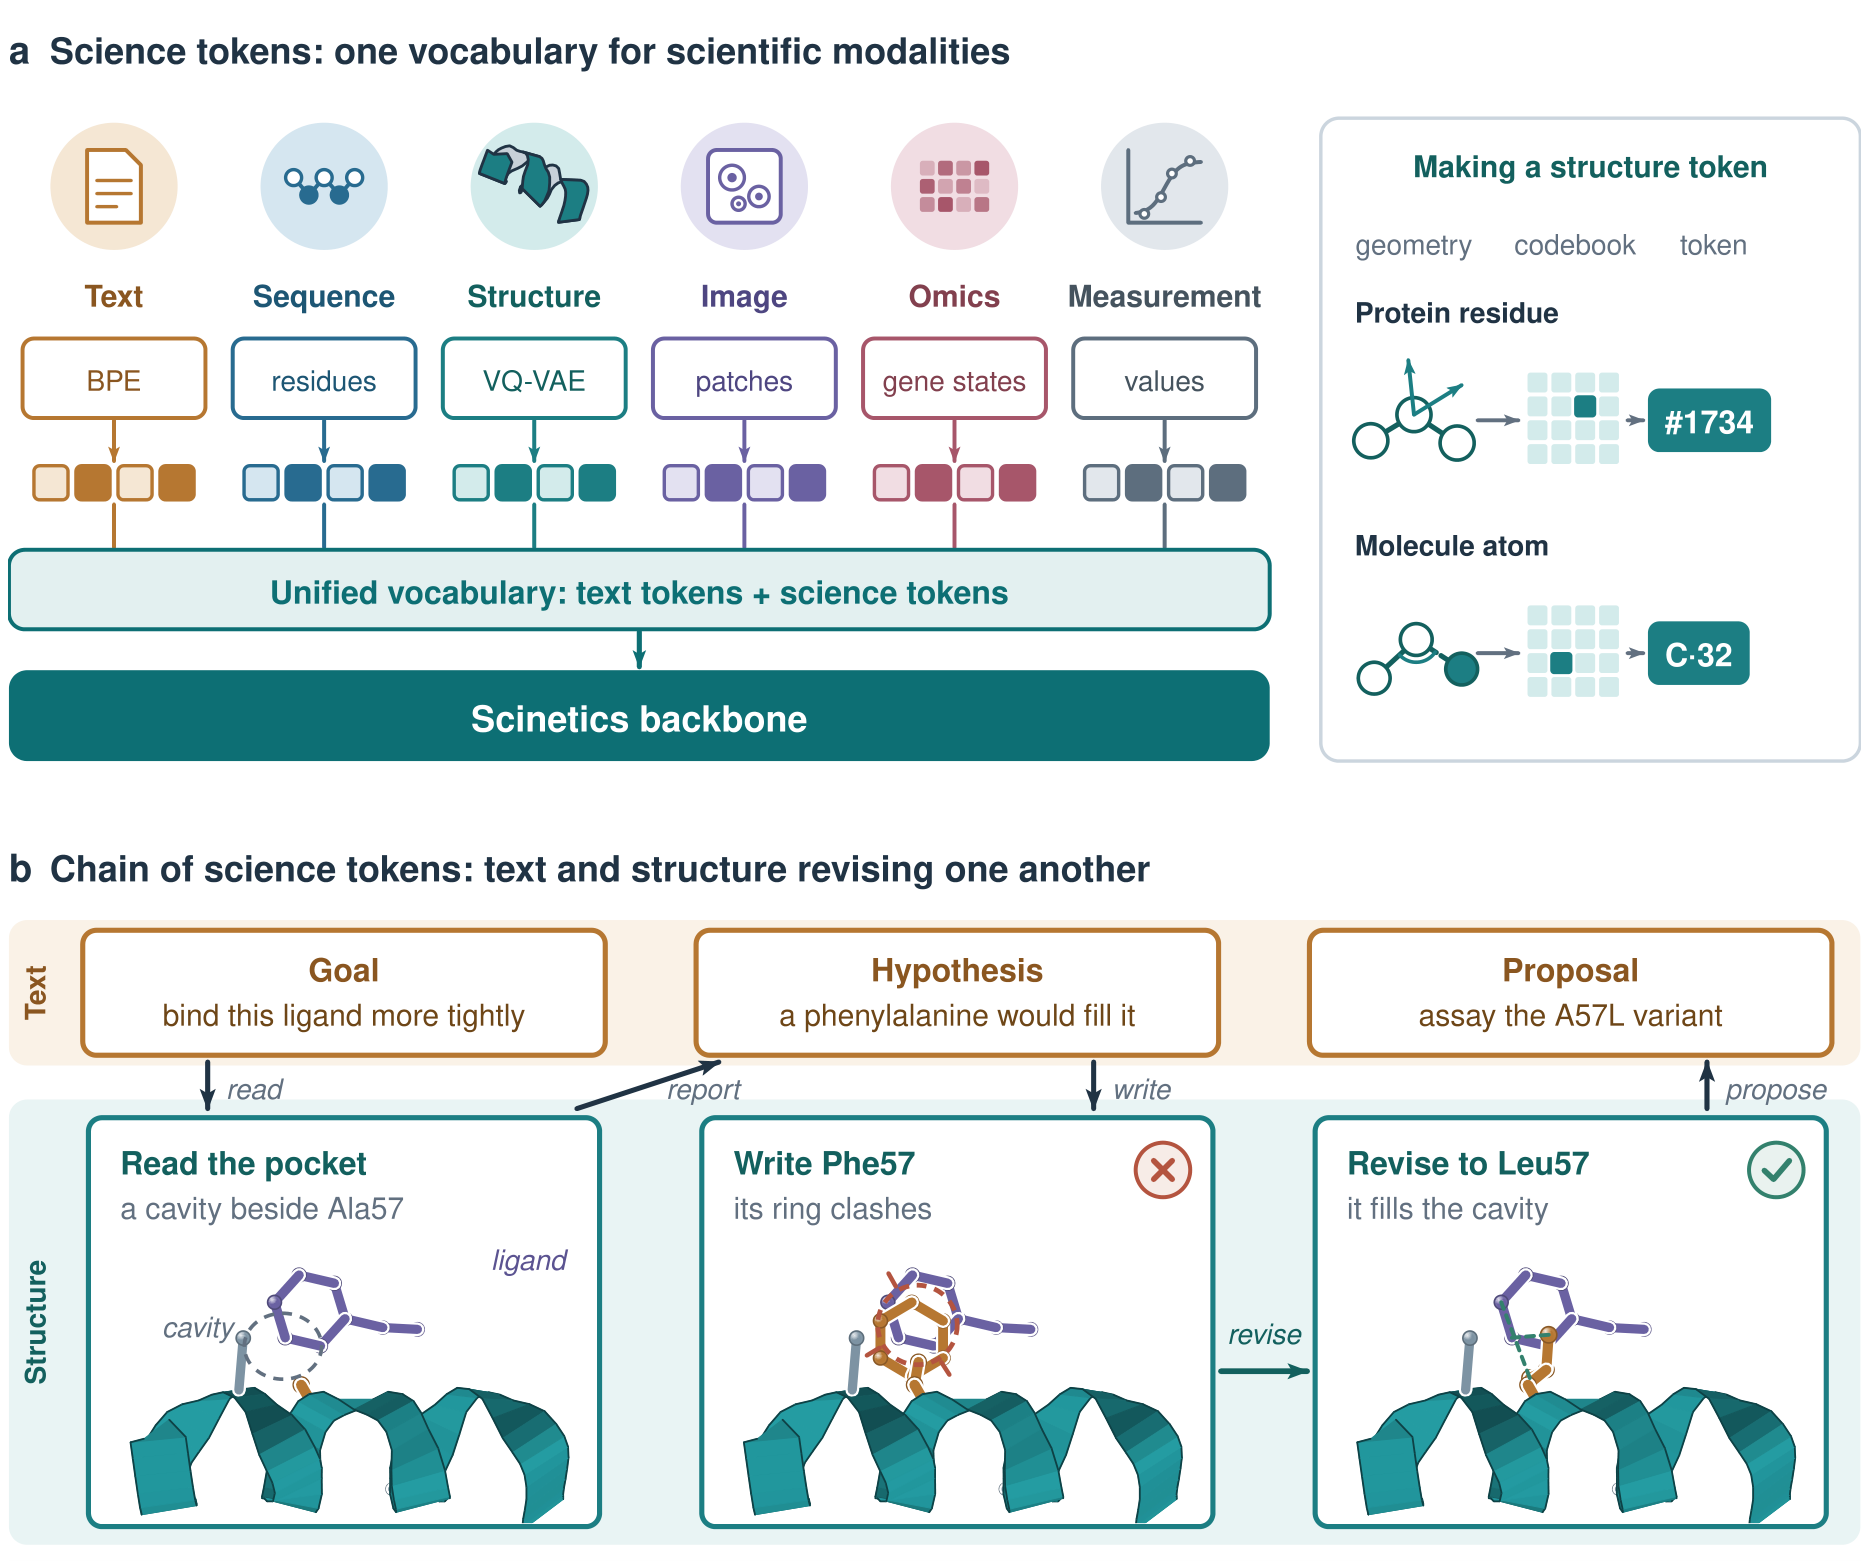
科学 Token 链进一步要求:科学对象必须真正改变后续推理。在 Perspective 的概念示例中,模型先读取蛋白质口袋,尝试用一个更大的侧链填补空腔;几何检查发现它与配体冲突后,模型再换成更合适的侧链,最后提出实验建议。
这里的“思考过程”留下了一组可以检查的坐标。改变口袋几何,模型应该相应调整设计;只把同一个分子旋转一下,结论则应保持稳定。这样的检验,能帮助我们判断模型是否真正使用了科学信息。
02 科学超级智能,要跨过两道门槛
专用科学模型擅长深入一个任务,通用大模型擅长跨任务理解与推理。我们想探索的是:能否把这两种能力放进同一个模型?
在 Perspective 中,我们将科学超级智能(Scientific Super Intelligence,SSI)定义为一次“双重跨越”:同一个固定模型,既在专业科学任务上超过相应的垂直专家模型,又在广泛科学推理上超过同等参数规模的通用语言模型。
以结构预测为例,目标是在一致的评测条件下超过相应的专业系统;在更广泛的任务中,模型还需要理解数据、进行定量推理、编写代码和规划实验。这要求科学表示、专业能力与通用推理共同成长。
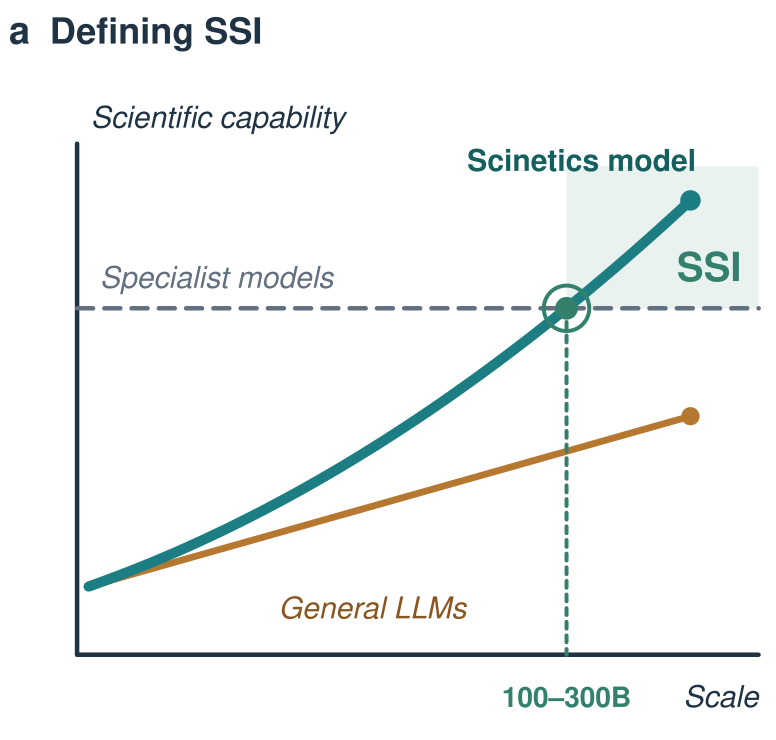
我们提出了一个值得检验的规模窗口:1000 亿至 3000 亿参数,配合 10 万亿至 30 万亿训练 Token。它综合考虑多模态能力所需的容量、已有训练规模、科学数据体量与计算预算,是下一阶段的研究假设,而非已经确定的最优解。
验证这项假设,需要沿不同模型规模测量能力曲线,观察两道门槛能否同时跨过。训练 Token 也要与独立证据区分开:同一份数据被反复训练会增加计算量,却不会凭空增加新的实验事实。模型扩大之后,真正稀缺的仍可能是高质量的科学反馈。
03 ScienceRSI:让科学证据训练下一代模型
科学数据并不缺少“结果”:数据库里有大量序列、结构与测量。但从提出假设、比较候选到接受证据的推理过程,往往没有被完整记录。只依靠人工撰写这些轨迹,难以支撑下一阶段的训练需求。
我们由此提出 ScienceRSI,即科学递归自我改进:让这一代模型参与生产下一代模型的训练材料,让外部科学证据决定什么值得被学习。
这条循环从较小的模型和基于它构建的科学智能体开始。它们在真实任务中提出假设,生成候选科学 Token 链,留下每一步的科学状态。模拟器、数据库、实验与领域专家随后参与验证;筛选后的轨迹用于训练更强的下一代模型,新模型再进入下一轮探索。
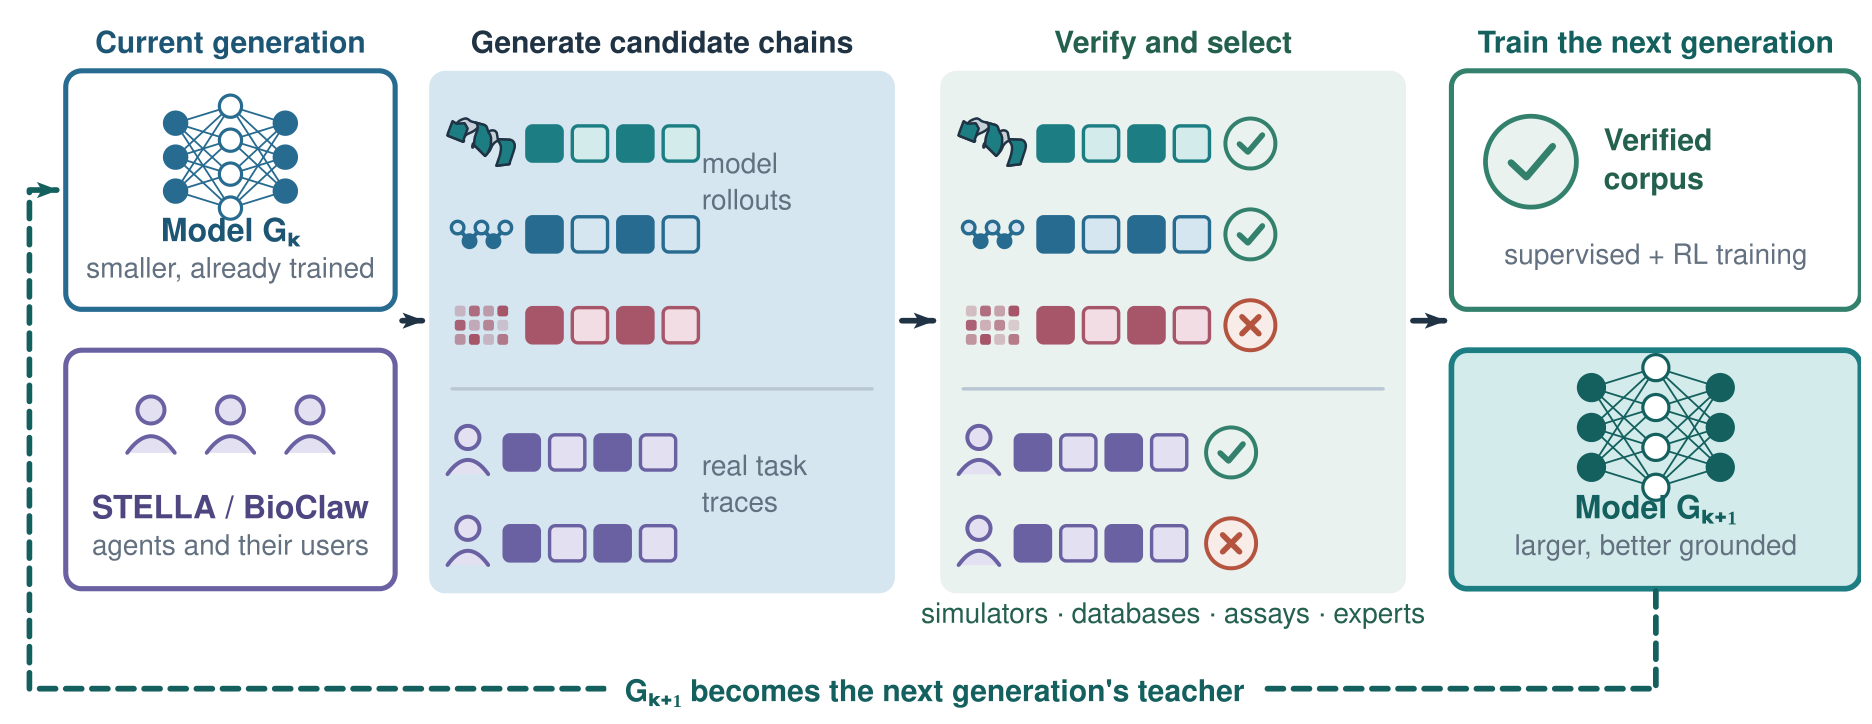
在这个过程中,失败同样有价值。一次结构冲突、一个无法复现的结果,都可以告诉模型哪些路径不值得重复。预测、模拟、实测和独立复现需要分别标记,让每条经验携带与其证据相匹配的可信度。
我们关心三个实际问题:生成的候选有多少通过验证?有多少任务具备可靠的验证方式?新一代模型在未参与训练的任务上是否变得更强?这三类指标分别对应验证通过率、验证覆盖率和独立评测增益。
ScienceRSI 因此是一条需要逐代验证的研究路线。它能走多远,取决于模型能否接触新的科学问题,也取决于验证工具和实验反馈能否跟上。每一轮有价值的改进,都应能追溯到更可靠的证据和更好的任务表现。
04 从消耗 Token,到积累科学资产
如果 AI 生成了两条同样长度的蛋白质序列,它们消耗的输出 Token 可能相同,但科学价值可以相差很远:一条只是候选,另一条已经经过实验测量,并能在明确条件下完成目标反应。
这也是 Perspective 提出 Science-token economics 的出发点:把计算消耗与科学成果的价值分别衡量。Token 数量适合记录计算;成果是否有用,则需要看证据、适用条件和后续用途。
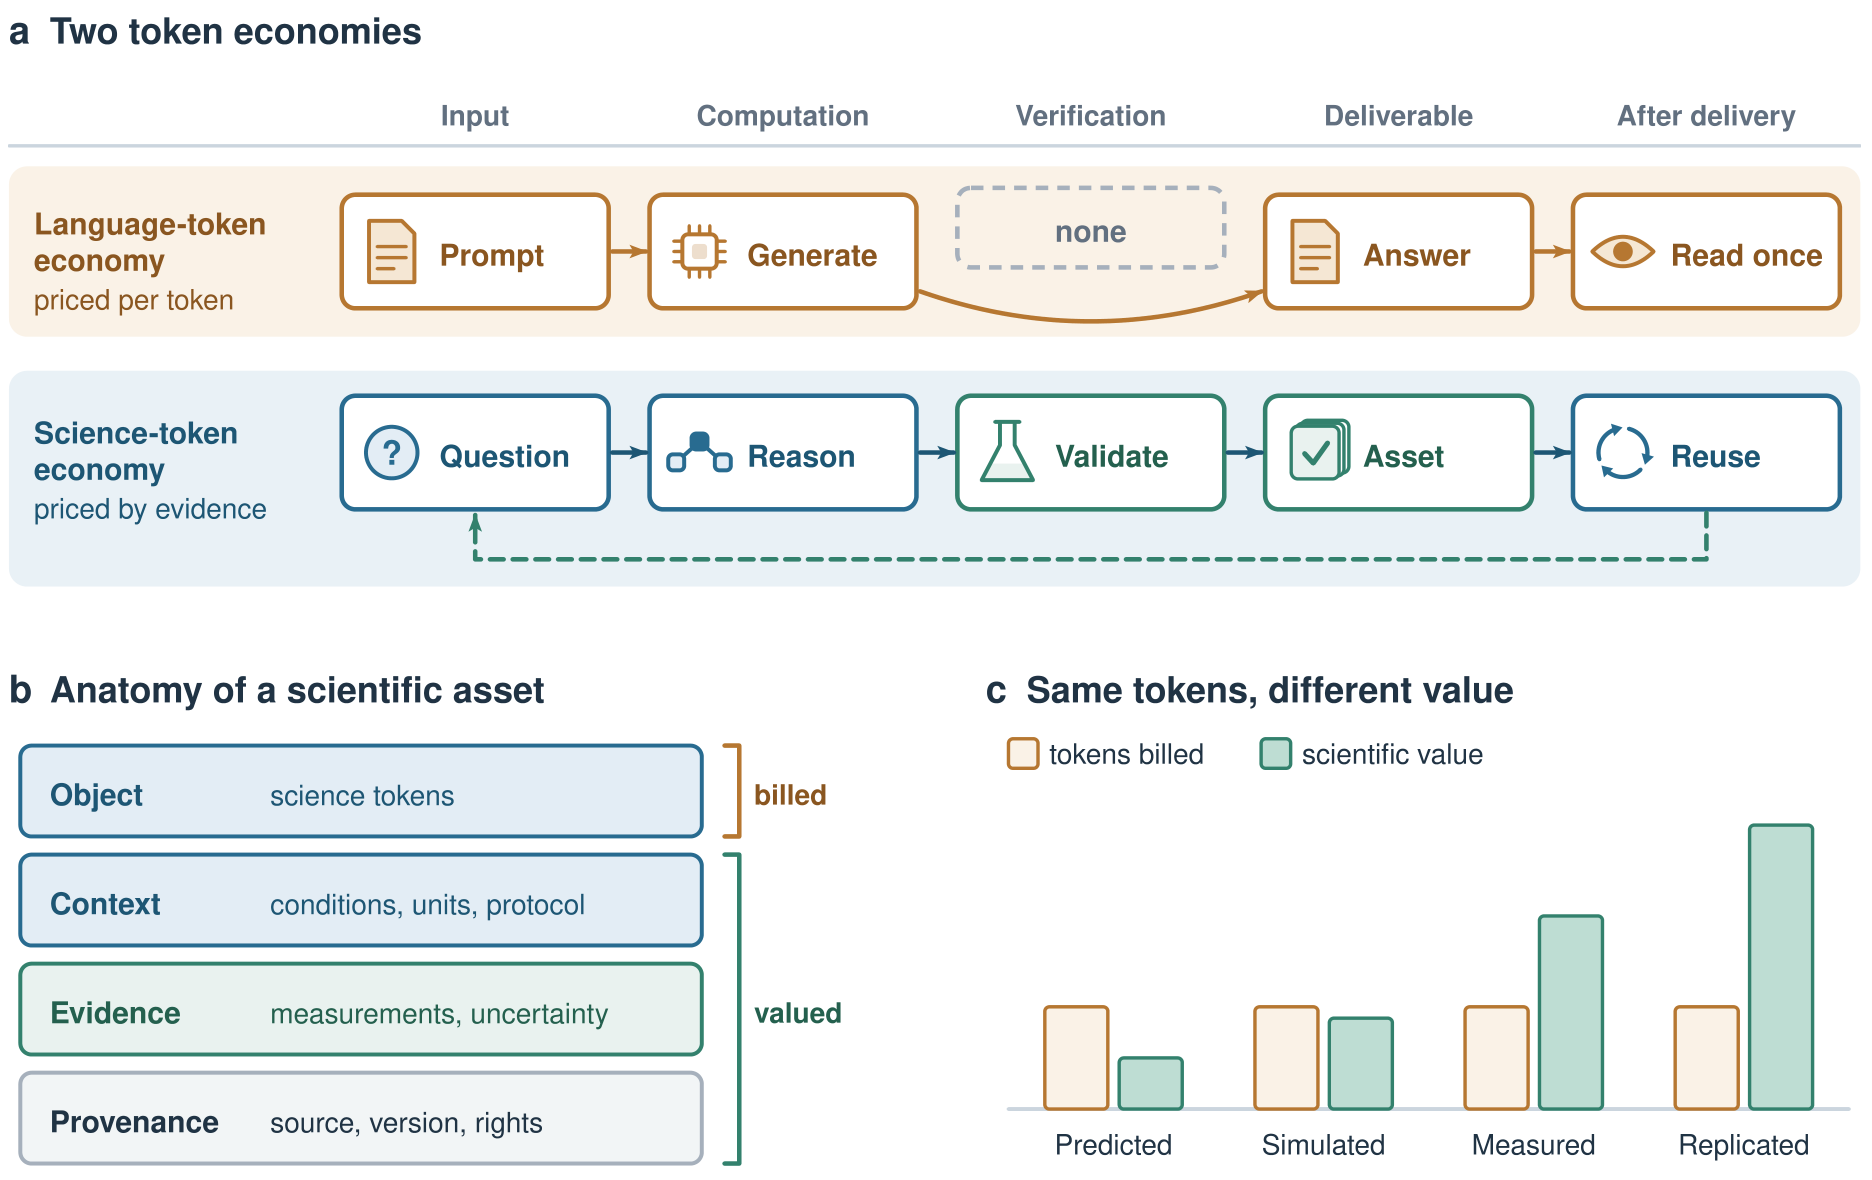
我们设想的科学资产,由四部分共同组成:对象本身,例如序列或结构;上下文,例如单位、条件与实验流程;证据,例如测量结果与不确定性;来源信息,例如版本、验证记录与复用权限。
随着一个候选从预测走向模拟、实测和独立复现,附着在它上面的证据不断丰富。它既可以帮助实验室作出决策,也可以进入后续模型的训练与评测;负面结果和适用边界同样需要保留下来。
这为科学 AI 带来另一种增长方式:每完成一次任务,都有机会积累一份可追溯、可复用的成果。未来值得衡量的,是这些成果为下一次研究提供了多少可靠信息、节约了多少验证成本。我们将其概括为科学价值密度;具体价值仍需结合证据与用途判断。
05 一个起点:在酶设计中实践结构链
这张路线图,从哪里迈出第一步?在 Chain of Structures(COS)中,我们选择酶设计作为科学空间推理的早期案例。工作由来自 MIT、哈佛大学、剑桥大学、香港科技大学和 Scinetics 等机构的研究人员共同完成。
从一条化学反应出发,COS 分四轮搭建蛋白质:先确定催化核心,再完善活性位点,接着构建全局骨架,最后补全序列与侧链。每一轮都产生实际的结构状态,并把已经形成的几何约束传给下一轮。语言推理与结构生成由此持续衔接。
在技术报告的酶设计基准对比中,COS 六项指标有五项排名第一。三级酶分类一致率 EC3 达到 57.0%,高于 CodeFP 的 55.3%;结构置信度 pLDDT 达到 79.3,结构自洽性 TM-score 达到 0.729。去掉推理链后,EC3 降至 53.4%,支持了中间推理步骤的作用。
这些结果提供了计算层面的初步证据,真实酶活性仍需湿实验检验。COS 展示了结构链的可行起点;更广泛的科学 Token 链、跨代训练循环和 SSI 目标,需要在后续研究中继续推进。
我们希望科学 AI 留下的每一步思考,都能接近可检验的科学对象;完成的每一次任务,都能成为下一次研究可用的经验。
延伸阅读与项目链接