过去十年,AI for Science 已经悄悄走过了好几个周期。“很多人还没看清上一个,下一个已经在水面下开始涌动。”张载熙对「新物种」说道。他是香港科技大学化学与生物工程系的助理教授,也是 Scinetics(科理新序)的创始人& CEO。目前,Scinetics 已完成首轮融资。
2019 年,AI4S 还是一个冷门方向。彼时的做法也朴素:找到一个具体的科学问题,设计一套算法,训练一个模型去解决它——比如预测材料的属性,或者设计蛋白质的序列。
但正在读博的张载熙,还是选择了这个方向。此时的 AI4S 正处在第一个周期里,为每一把锁配一把钥匙。
这个周期的巅峰之作是 AlphaFold2,它一举攻克了困扰生物学界半个世纪的蛋白质结构预测问题。张载熙也在这个周期里做出了不错的工作:分子筛选模型 MGSSL、药物分子生成模型 FLAG、蛋白质设计模型 PocketGen、RNA 药物设计模型 RNAGenesis,每一个都做到了细分领域的 SOTA。
但模型做得越多他愈发意识到,单点能力再强,也不等于科学发现的能力。
一次完整的蛋白药物设计,有时要协调二十多个工具、反复迭代,AlphaFold再强,也只解决了其中一步。张载熙用木桶的短板效应类比道:“单块板加高,桶里的水不会变多。”
行业也很快意识到了这点,AI4S 也随机进入了第二个周期,科学智能体的时期。
大语言模型开始充当科研流程的调度中枢,将分散的模型、数据库和实验工具串联为一体。如果说专用模型是深耕某个领域的专家,智能体则更像一位项目经理,未必亲自完成每个环节,却深谙何时该将任务交予哪个工具。这一时期,张载熙与团队开发了 STELLA、BioClaw 等科学智能体,并将相关技术落地于 LabOS 实验室操作系统。
但智能体仍然没有解决最根本的问题。今天的大多数智能体,本质上仍是一个语言模型在调度外部工具。
它可以调用蛋白质模型,却未必真正理解三维结构;可以读取组学分析结果,却难以直接推理背后庞大而稀疏的数据矩阵。科学数据有自己的语言,碱基序列、三维结构、表达矩阵、显微图像,而智能体的母语是文本和代码。于是整个流程变成一场反复的翻译:每翻译一次,就损失一次信息,误差沿着任务链逐级放大。
“专用模型解决一个点,智能体连接很多点,但中间还缺少一个真正理解科学世界的模型。”历经过去多个AI4S周期后,张载熙把下一个周期押注在AI4S多模态推理基座模型上。“Scinetics 想做的是一个多模态基座模型:DNA、RNA、蛋白质结构、组学矩阵、显微图像、实验记录,这些数据直接作为模型的输入,如同‘母语’一般,不再先转成文字。”
在这个基础上,模型可以对多模态科学数据做长程推理,他称之为“Chain of Science Tokens”,用一条连续的推理链,去解决系统级的科学问题。第一个版本面向生命科学,之后后张载熙计划覆盖材料科学、量子物理、航空航天和芯片设计等方向。
事实上,海外巨头已经先后入场。
2025年10月,Anthropic推出Claude for Life Sciences,把Claude嵌入生命科学工作流;今年4月,OpenAI推出聚焦生物推理的GPT-Rosalind;6月,Anthropic又发布了面向科学家的AI工作台Claude Science;Google DeepMind手上,则握有Gemini for Science平台和一路推进到药物设计的Isomorphic Labs。继语言、代码和多模态之后,科学正在成为基础模型竞争的下一个前沿。
毋庸置疑,下一个AI4S周期已是暗流涌动。
十分钟,到二十年
之前一家做免疫方向的国家实验室,研究急性髓系白血病近二十年。这种血液肿瘤复发率高达 70%-80%,可用的靶点却极少。围绕老靶点设计药物,受基因通路和调控网络限制,有些副作用避不开,找新靶点的任务迫在眉睫。
“后面找到了我,在科学智能体 STELLA 私有化部署后,十分钟内交回一份候选列表,排在首位的靶点从未被文献报道过,也没人做过实验。实验室随后在多个细胞系上验证,拿到了初步的正向结果。现在他们正围绕这个靶点设计抗体药物。”张载熙希望,它能走到临床管线。同样的工作换成研究人员来做,就需要——文献检索、数据库比对、候选初筛。“通常要数天到数周,还不一定能找到有效的突破口。”他介绍道,十分钟对几周,不只是快慢的差别。STELLA 给出的最高优先级候选,不在这个研究了二十年的团队此前重点探索的方向里。更重要的是,它展示了一种可能:AI 不只是加快检索和分析,也开始帮科学家拓展假设空间,提出没人试过、但值得一验的新方向。STELLA 在 2025 年 7 月上线,张载熙将其称之为第一个面向生命科学的自进化智能体。
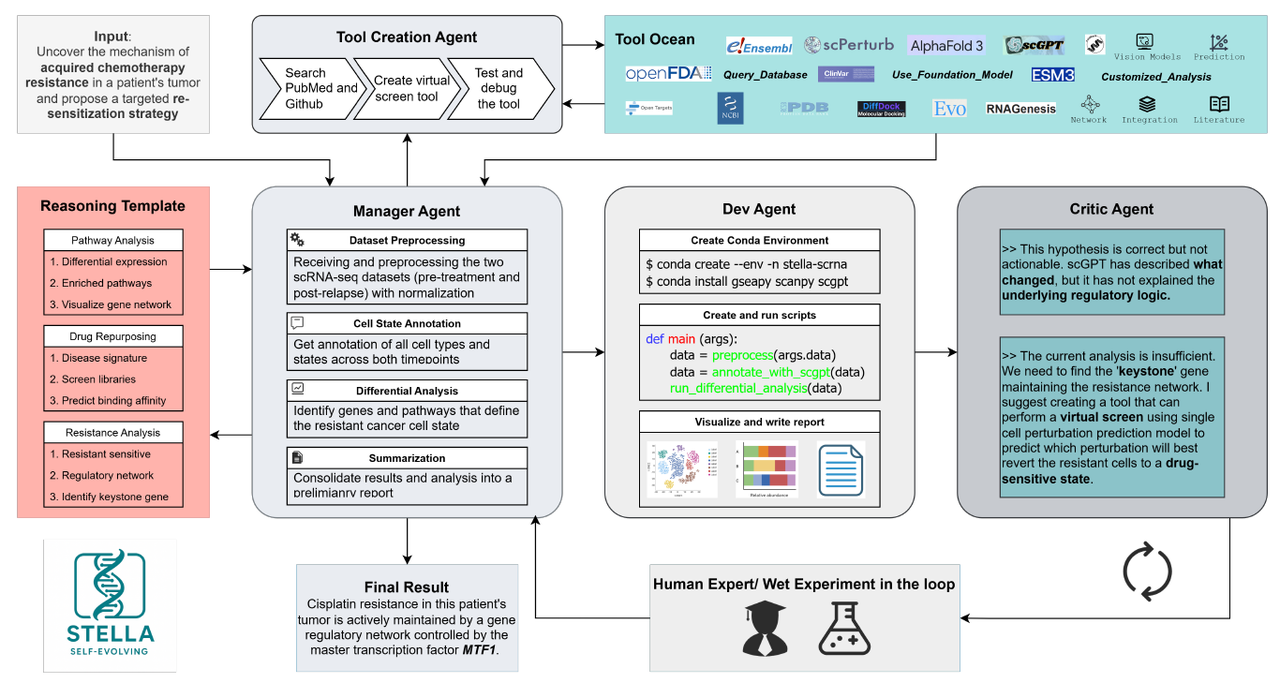
所谓“自进化”,是指它不只调用现成的模型和工具,还会从任务反馈中积累经验,把成功和失败的路径整理成可复用的思维模板,用于之后的类似任务。
STELLA 能在十分钟内给出一个没人试过的靶点,背后是他五年的单点模型积累。2020 年的 MGSSL,从分子基序出发做预训练,用于分子筛选;2022 年的 FLAG,根据靶点蛋白生成小分子;2023 年的 PocketGen 做蛋白质口袋设计;2024 年的 RNAGenesis,用 RNA 基础模型设计小核酸药物。四个模型对应生命科学研发的四个环节,每一个都做到过当时的最好水平。其中 PocketGen 被认为是全球首个蛋白质口袋序列与结构协同设计算法,斯克里普斯研究转化研究所创始人 Eric Topol 在《Science》的专家述评中将它与 AlphaFold 3 并列,实验效果超过了诺奖得主 David Baker 团队当时的 RFDiffusion 系列。但单点模型做到这个程度,局限也就露出来了:单个任务再强,覆盖不了一套完整的科研流程,张载熙转向科学智能体。这也是学界看好的方向,《Nature Methods》(《自然·方法》)把面向科学的 AI 智能体列入年度值得关注的方法。围绕 STELLA,张载熙和团队又做了两件事。一是 BioClaw,把智能体接进即时通讯软件。他向「新物种」演示过一个场景:课题组在群里讨论 RNA-seq 的结果,艾特一下 BioClaw,把 deseq_results.csv 发进群里,让它画火山图、标出 FDR 小于 0.05 的基因,并返回差异表达基因的数量、上下调情况和重点候选。BioClaw 也有网页版和本地部署版,接进即时通讯是为了让研究者随手就能推进工作。“这样,我们在出门时也可以用手机看一下现在实验的进展。”他表示。计算运行在本地容器中,敏感数据不会上传,这对不少实验室是硬性要求。目前 BioClaw 社群有 1200 多人,收到 500 多份共创者申请,并与美国生物科技上市公司 Ginkgo Bioworks 达成了合作。二是 LabOS,把智能体带进物理实验室,将智能体、具身模块、视觉模型和可穿戴设备集成在一起。张载熙是这项工作的共同第一作者,相关成果曾在 2026 年的英伟达 GTC 、CES 上展示。但这些全部做完,张载熙也触碰到了智能体这个方法的上限。他在测试过近期上线的通用科学智能体产品,得出的结论和审视自家产品时一样:它更像一个工具调用的库,真让它提出一个新的科学假设,要么过度幻觉,要么过度保守。“很多信息就是在调用、转换的过程中损失,产生误差。这种推理是一步步的,是错误累积的形式,所以最后它的错误会被放大得很大。”张载熙说。所以,要再往前走一步。
Scientific Token:科学智能计费单元
下一代 AI4S 基座模型要解决的第一件事,是把结构、序列、组学、图像、文献、实验流程、湿实验读数这些原本各说各话的科学数据,转换成模型能统一理解和处理的基本单元。
这样模型看到的不再是彼此割裂的文本、序列和图像,而是同一个科学问题的不同侧面,可以直接在它们之间建立联系、进行推理。张载熙把这种科学模态的基本单元称为 Science Token,这个概念第一次公开亮相,是在今年 7 月初上海的人工智能与生物医药生态大会(AIBC)。
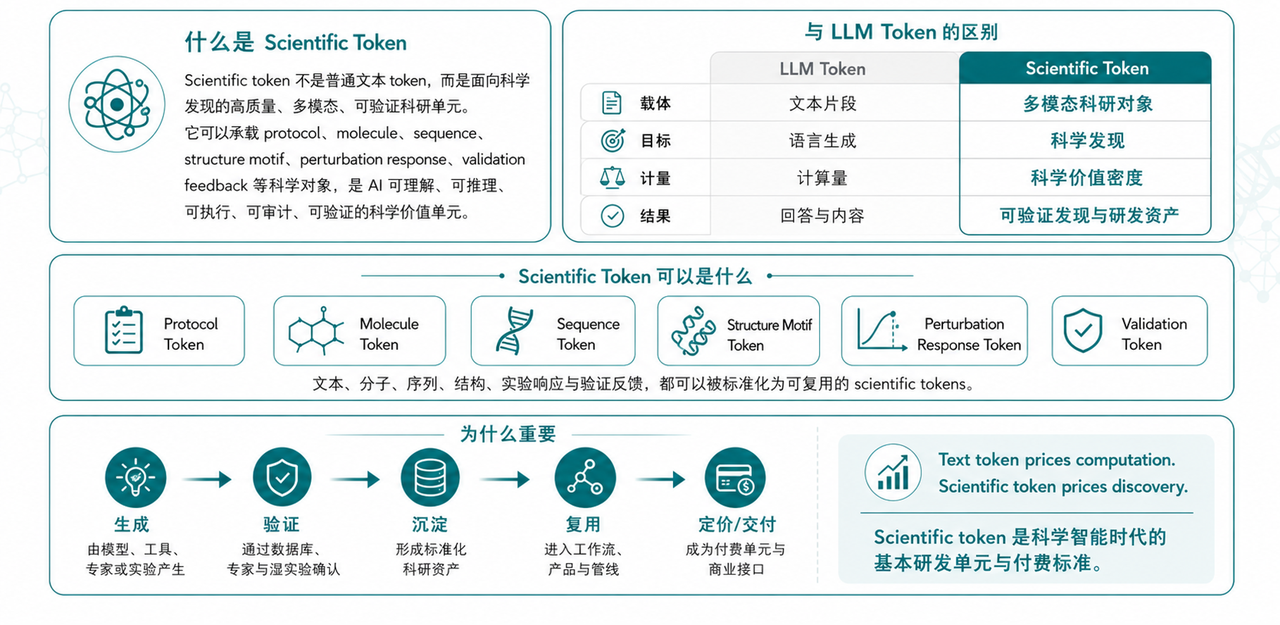
Scinetics 基座模型的第一个版本将聚焦生命科学的中心法则:DNA 到 RNA 到蛋白质,再到功能和表型。不同模态的数据在同一个模型中处理,在统一的表征空间中对齐,让模型能够跨越模态做长程推理。张载熙的概括了四个方面:从 language token 走向 scientific token;从工具使用走向科学发现;从离线预测走向实验验证;从静态模型走向自我进化。他给这个目标起的名字,是 AI for Science 的“ChatGPT 时刻”。与智能体的关键区别,在于推理发生在哪一层。他的设想是,未来的科学基础模型能把 AlphaFold、ESM 等垂直模型各自干的事统一到一个模型内部,减少多模型调用和格式转换带来的信息损失,“直接在蛋白质的空间中做科学推理,而不是只能在文本层面做推理”。但眼下能做到什么程度,张载熙向「新物种」也说得诚恳。“类似于 AlphaFold 那样的变革,从过去大概率大家觉得它 90% 都是失败,到现在 90% 都是成功。”抗体设计现在的行业水平,包括 Scinetics 自己最好的模型,十条设计序列往往只有一两条能成,这已经是 SOTA。他希望基座模型在这类标杆任务上做到 80%、90%。AlphaFold 之前,看蛋白质结构靠冷冻电镜和 X 射线衍射;AlphaFold 出现之后,结构预测第一次在大量场景中成为研究者可以直接依赖的工具。而从 10% 到 80%,中间隔着一个数量级,目前也没有任何证据表明它能被跨过去。真要跨,最后还是看数据。对行业来说,scientific token 还有一层更远期的设想,成为一种标准化的交付和计价单元。今天的大语言模型的 token 衡量的是计算消耗。张载熙希望,未来的 scientific token 不只衡量计算量,还能对应一次科学任务产生的发现价值。“总结成一句话就是:Text token prices computation. Scientific token prices discovery(文本 token 衡量计算,科学 token 衡量发现)。”这套计价方式仍在探索之中。谁来定义一次科学发现的价值,如何衡量,如何在交付前定价,都还没有答案。但对张载熙来说,提出 scientific token 的意义不仅是一种新的模型表示方式,也是在尝试为 AI for Science 建立一套统一的技术和交付标准。
“最难的一环,在实验台上”
模型和数据准备得再好,科研闭环还有一半要发生在实验台上,这也是最难加速的部分。
不是没有设备,美国的 Ginkgo Bioworks 和国内不少公司都有成熟的自动化实验室方案。问题在于,设备主要面向高通量、高度固定的流程,一旦改动 protocol,重新配置设备和程序的成本就很高。“做了一个实验之后,想去做另外一个实验,需要花很多成本去重构它的程序和流程。”张载熙解释道,而探索性的、定制化的实验,也是科研里最有价值的部分。Scinetics 的解法是用科学具身平台解决这个问题:搭建一个包含 200 多种实验仪器的沙盒环境,让模型在其中自进化迭代,训练出 Agentic-VLA 等一系列科学具身模型。具体而言,是让智能体来管机械臂的训练。
一个双臂拧离心管盖的动作,被拆成抓取、对准、咬合螺纹、拧紧四步,智能体自己写出检查工具,判断每一步有没有做到位,再写出恢复工具,在失败时重来一次。这些纠错轨迹又回过头去微调机器人的策略模型。
在合作实验室里,Agentic-VLA 等模型已经能连续完成一组酶活性测定。目前,稳定运行的时间仍以小时计。“如果是更长的周期,它其实是很容易发生一些错误,需要人在其中去做相关一些监督,还包括一些纠错。”张载熙说。
他还提到一类被系统性浪费的实验数据:失败数据和中间数据。论文发表的只是最终结果,合成产率、反应速度、中间图像,从来没有被整理成模型能用的反馈。在和一家国内合成生物学公司的合作中,Scinetics 部署了专门采集中间数据的设备,“用途之一是提前判断,做蛋白质合成、优化的过程中,有时候不需要等到最后一步才知道这条序列有用与否。”他介绍。
但当模型、数据和实验逐渐形成闭环,问题不只是如何让系统变得更强。另一个问题开始变得现实:这种能力的边界在哪里?
“答案也在我们公司的名字里。”张载熙具体说道,“Scinetics 是 Science 和 cybernetics 的合成,也是未来科学系统的控制论。”他对控制论的理解有两层:让系统变强,以及给它的能力划出边界。
而能力越强、门槛越低,第二层就越现实。十分钟找出一个没人试过的靶点,和十分钟找出一个不该被找出来的东西,用的是同一套能力。
这件事张载熙很早就在做。2024 年,他提出了生成式生物安全,围绕这个方向发过研究性工作和观点性论文,也是 NeurIPS 2025“生成式 AI 的生物安全保障”研讨会的核心组织者。
但在这样的科学系统里,人类扮演什么角色?
他的判断是现阶段人类依然是主导者。基础的科学数据分析,智能体和大模型都做得不错,但“去做什么方向,还有整体的科研的 taste,其实还是人类去主导的”。张载熙希望,智能体最终能自己提假设、主动探索,“从过去被动地拟合已有数据,到成为创造知识、引领发现的主角”,但现阶段仍处在初级的人机协同阶段。
跨界物理、生物与AI的助理教授
把系统当成一个可以被调节、也需要被约束的对象,这个视角可以追溯到张载熙的本科。
他本科就读于中国科学技术大学少年班学院物理方向;后留校攻读人工智能博士,师从刘淇教授;同期赴哈佛医学院联合培养,师从生物医学AI领域知名学者Marinka Zitnik教授;后在普林斯顿AI实验室随王梦迪教授从事博士后研究。
随后张载熙在腾讯量子实验室、微软亚洲研究院和百图生科均有相关工作经历。
回国前,张载熙手上有十多个海内外高校的教职 offer,其中一所美国 top 20 高校给出的 startup package 约 300 万美元,是该校面向新任助理教授开出的最大额度之一。此外还有国内外大厂和 frontier lab 的千万年薪邀请。
他最终选择了香港科技大学,并成立 HKSUT Scientific AGI Lab,。港科大给了张载熙的空间更大,也有着创业基因。他提到李泽湘和大疆等从高校科研走向产业的案例。在他的设想里,教授和创业者并不是两个需要先后完成的身份,而可以同时服务于同一个目标:把 AI for Science 从论文和模型推进到真实的科研系统。“我去香港科大,本来也是想创业的。”
张载熙把 AI for Science 和纯 AI 通往 AGI 的路径做了区分。
在他的理解里,AI for Science 不是 AI 单向改造科学,而是一个双向循环:先用 AI 加速科学发现,再让新的实验、发现和数据反过来训练更强的 AI,两者在同一个闭环里共同演进。也因此,这条路“会更加复杂一些”。
复杂的不只是技术。对于一家 AI for Science 创业公司,另一个问题是如何让长期技术投入和短期商业化同时成立。
他并不回避这一点,AI4S基础模型需要持续投入,但公司也需要在企业合作中找到稳定的商业闭环,“在真正通往Scientific AGI前,AI for Science必将经历多个周期,我们也做好了以长期主义穿越周期的准备。”张载熙说。
本文转载自公众号:Sinovum新物种,版权归原作者所有,如果侵权请联系删除。
如有科研合作、商务合作、产品体验及其他合作意向,欢迎联系我们:info@scinetics.ai