给模型两条蛋白质序列,它能预测两条链会用哪一面贴在一起吗?
在 FoldBench 的蛋白质–蛋白质任务上,Scinetics 的 AtomLM-9b 取得了 75.01% 的成功率,比 AlphaFold 3(AF3)的公开结果 72.93% 高出 2.08 个百分点。
AtomLM-9b 的底座是 Qwen3.5-9B。它拿到两条链的序列后,要像续写文本一样,依次为每个残基写下一个结构 token。难点在于,序列上相隔很远的两个残基,折叠后可能紧贴在一起;另一条链上的残基也可能恰好嵌入这个位置。这些接触关系,怎么写进 token?
01一个残基怎样写成一个符号
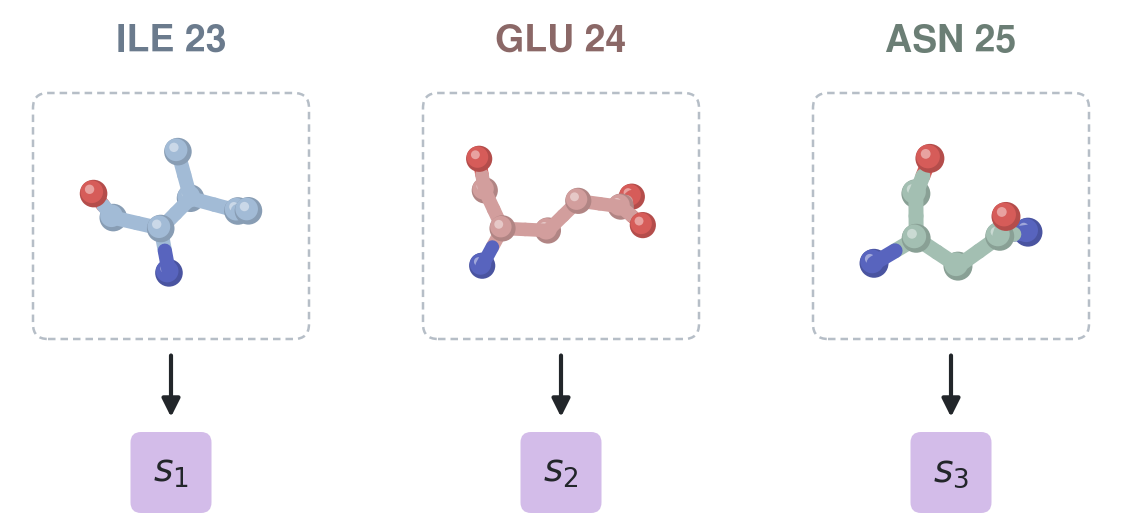
看泛素中相邻的三个残基:第 23 位是异亮氨酸,第 24 位是谷氨酸,第 25 位是天冬酰胺。把它们写成序列,只需要 I、E、N 三个字母。我们也给每个残基分配一个结构 token,但这个编号记录的是几何信息。同一种氨基酸,侧链朝向不同,或周围多了一个配体,都可能得到不同的编号。
训练分词器时,我们让编码器看到整个复合物。对界面上的一个原子来说,它的邻居既包括与它成键的原子,也包括空间上靠近它的另一条链上的原子。编码器先在这些邻居之间传递信息,再汇总到残基这一级。这样,一个残基的表示里就包含了它所处的结合环境。
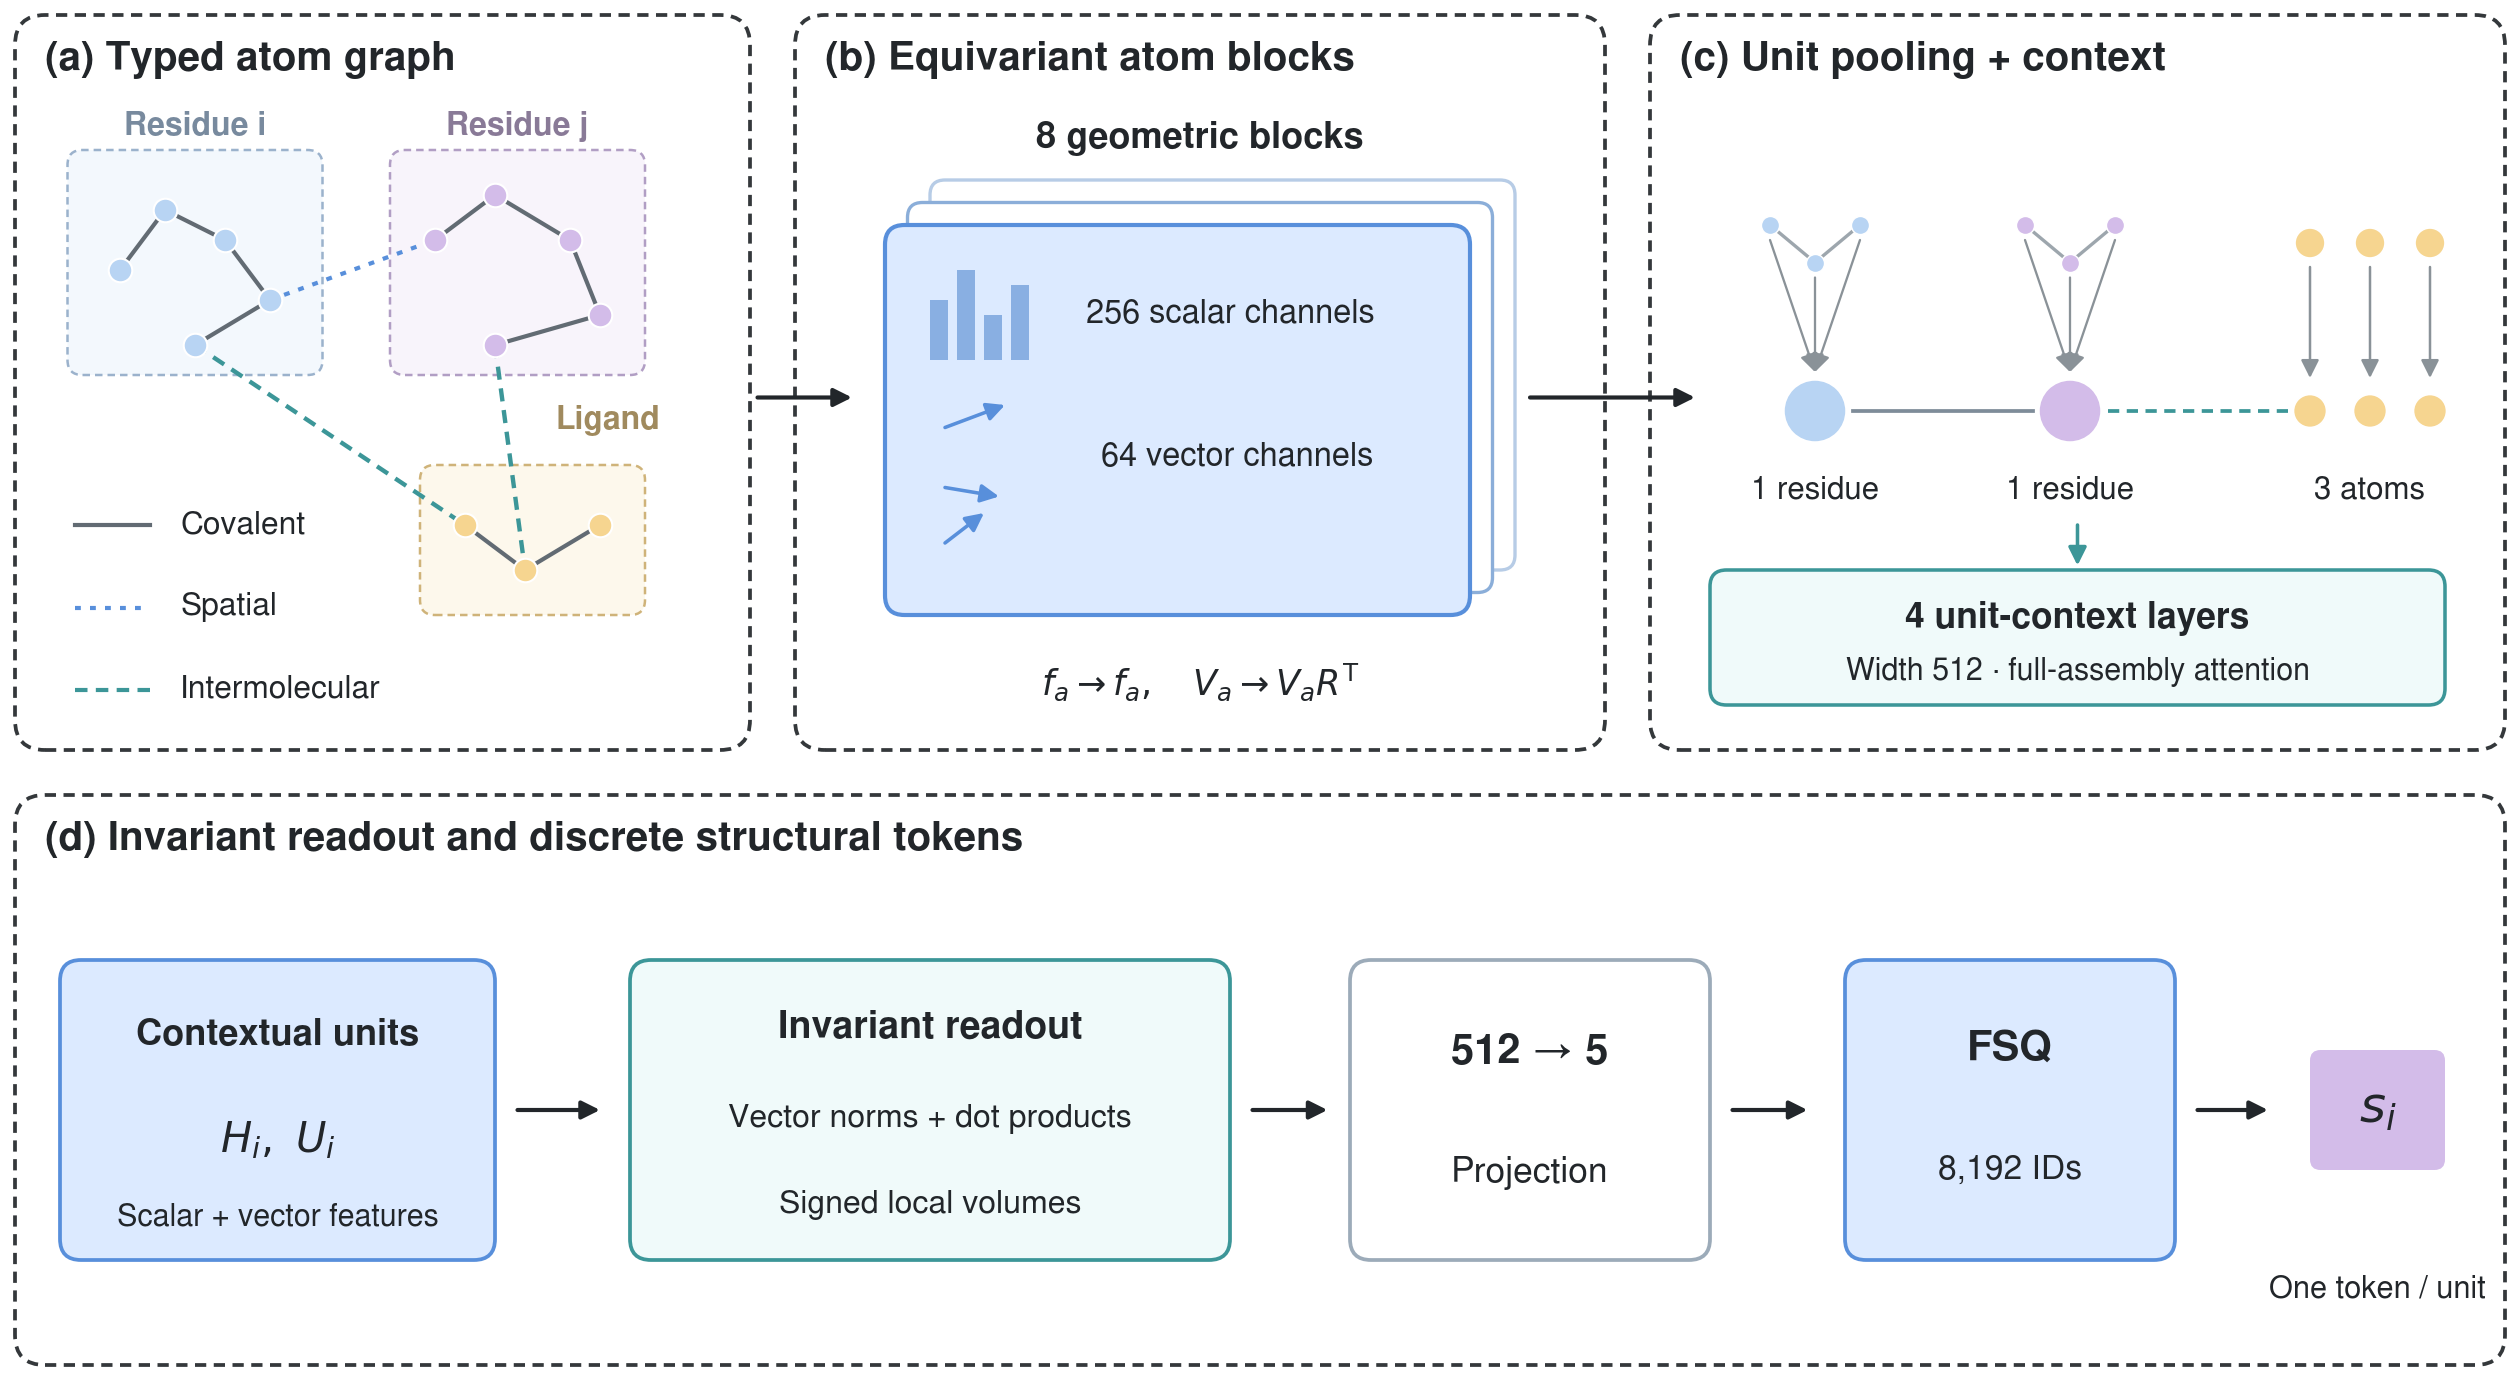
有限标量量化(FSQ)把每个残基的几何特征压缩为五个数。它们分别有 8、8、8、4、4 种取值,组合起来正好是 8,192 个编号。100 个残基就用 100 个编号表示。遇到小分子配体时,则给每个重原子分配一个编号,以保留配体内部构象的细节。
02让语言模型从序列写出三维结构
先做一个压缩实验:给分词器一份已知的三维结构,保留生成的 token,再让解码器根据这些编号、原子身份和化学键重建坐标。所有链和配体一起解码,因此既要摆对每条侧链,也要摆对不同分子之间的相对位置。
在 CASP14 和 CASP15 上,重建结构的全原子 lDDT 分别为 0.832 和 0.835。这个分数越高,表示原子与邻近原子之间的距离保留得越好。它回答的是从已知结构提取的 token 留住了多少几何信息。
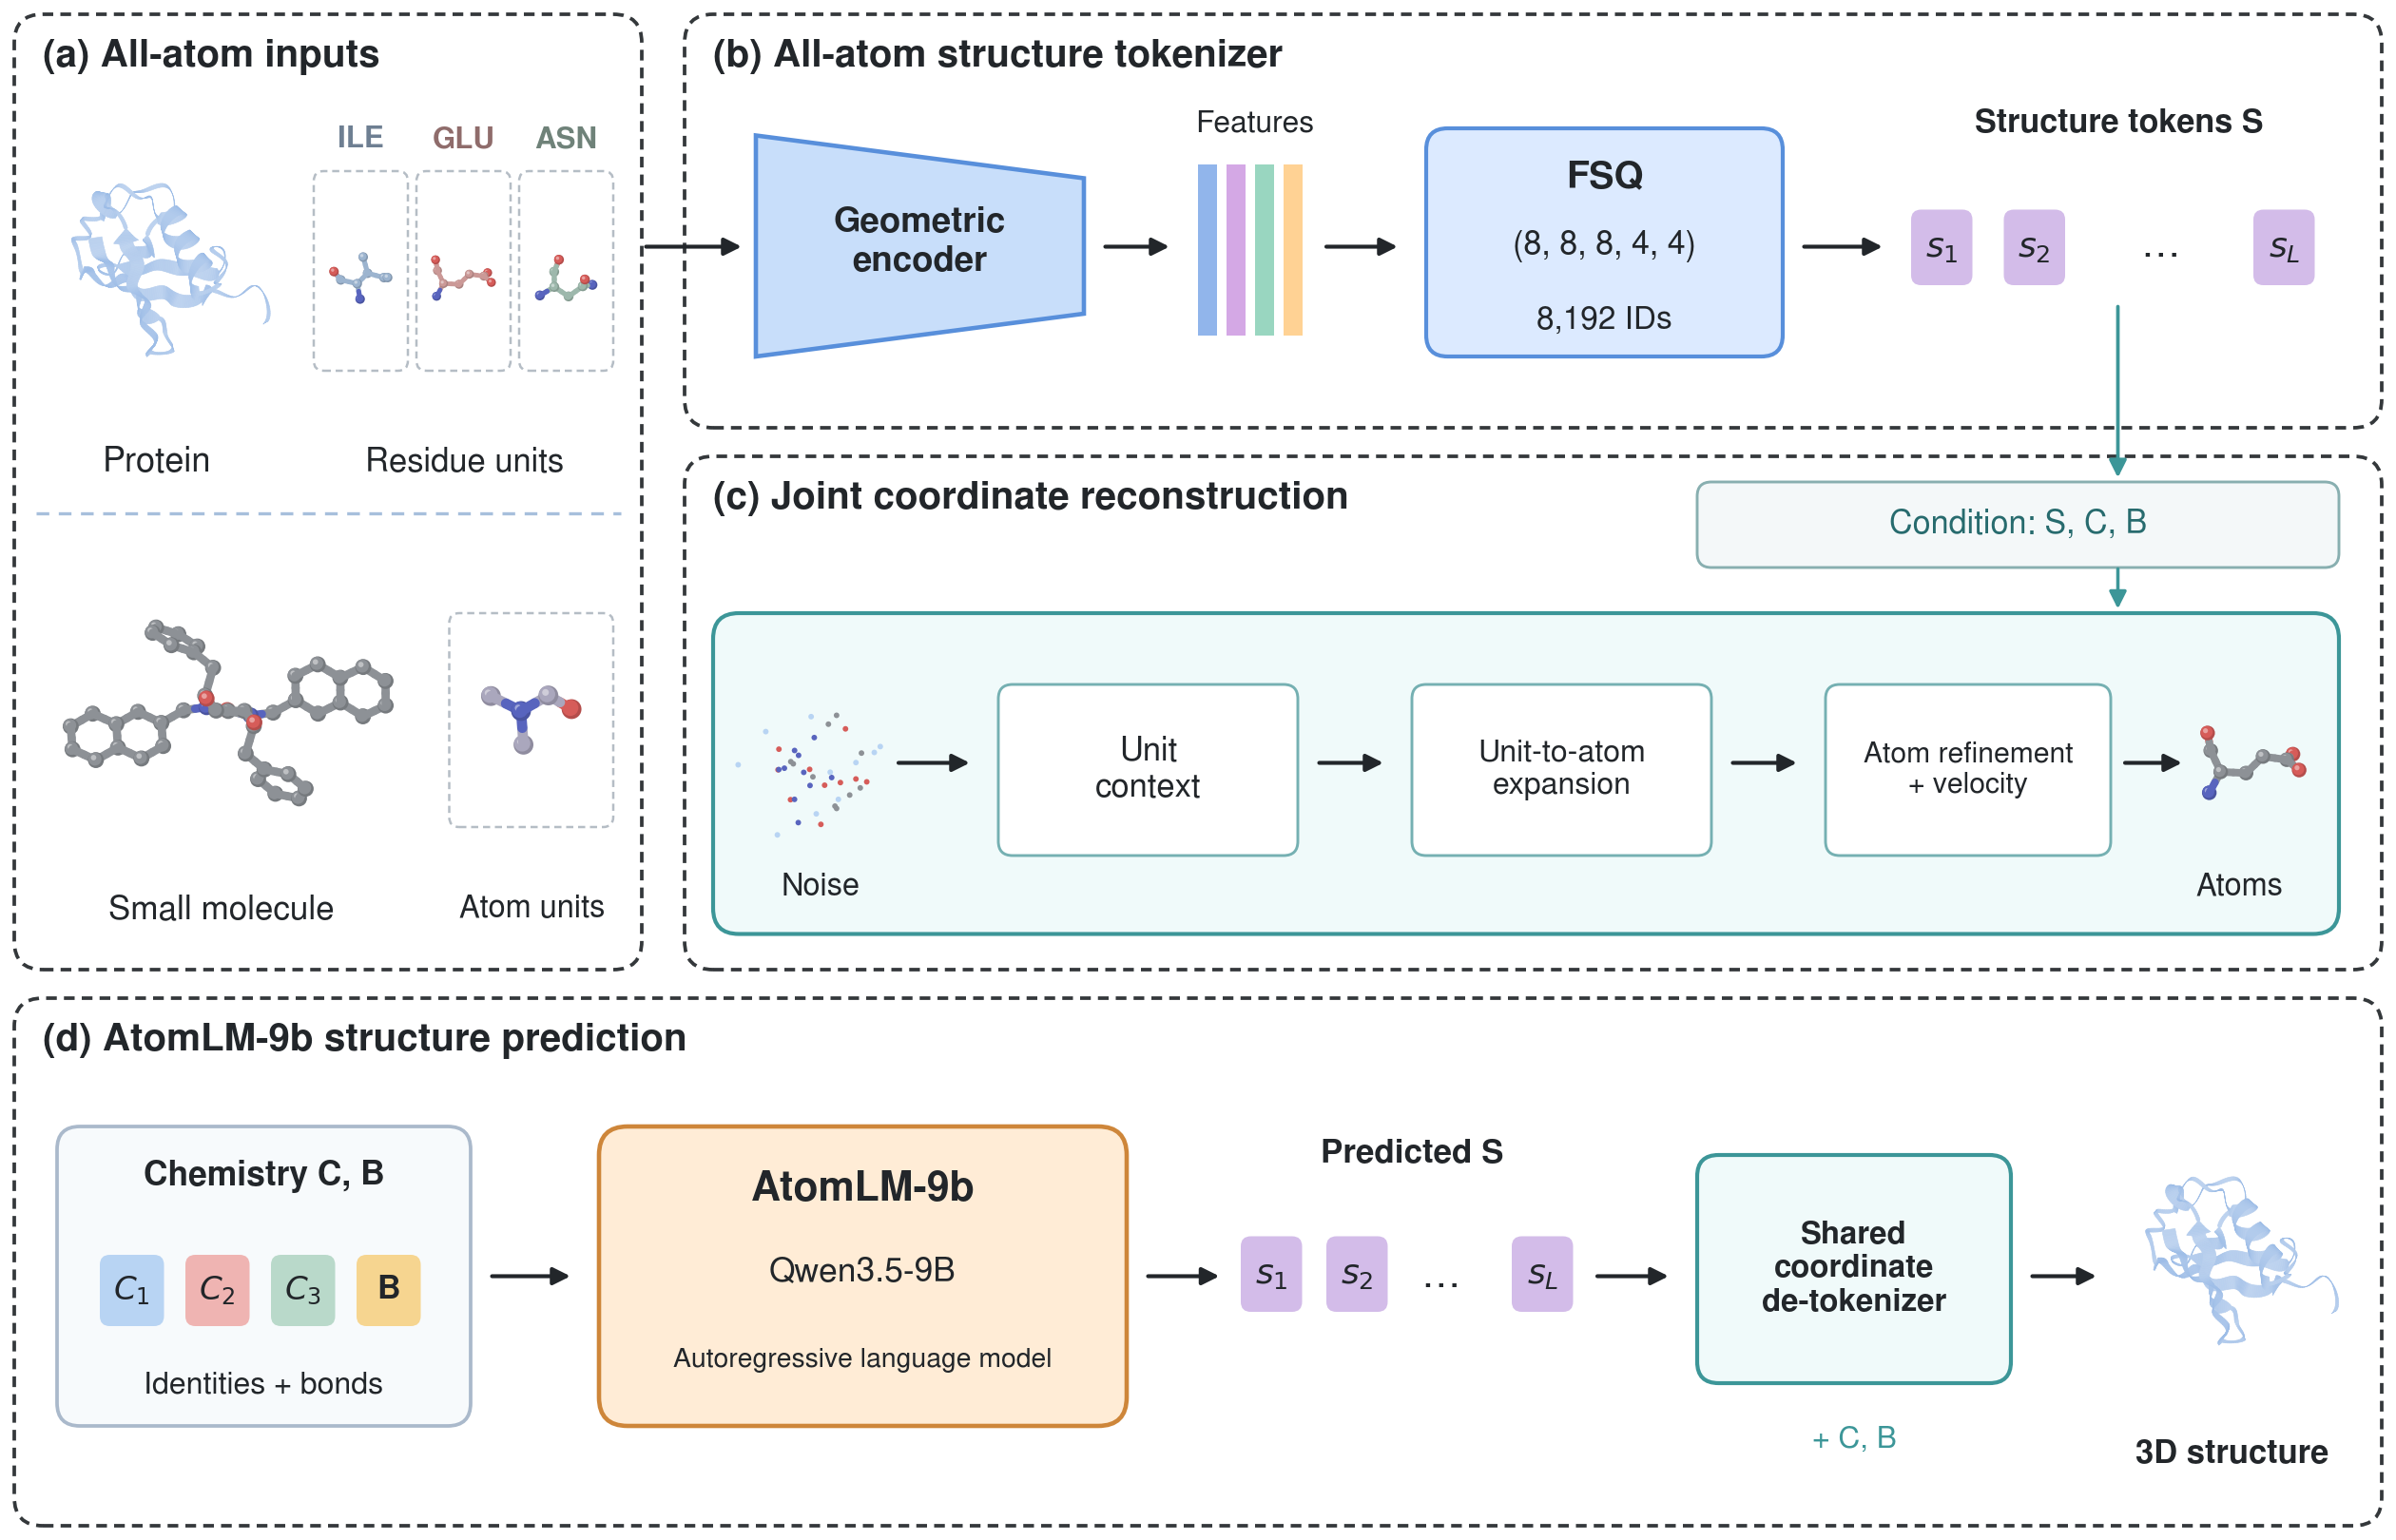
预测新结构时,多了一道更难的工序:真实坐标并不在手里,结构 token 也必须由模型自己生成。AtomLM-9b 先读入蛋白质或核酸序列,以及配体的原子和键,再依次预测各单元的编号。报告采用单序列、无模板输入,采样五组 token,每组从五个不同的噪声起点解码,最后用置信度模型从 25 个候选结构中选出一个。
03哪些任务超过了 AF3?
FoldBench 用 DockQ 衡量预测界面与实验结构的吻合程度,达到 0.23 就把该样本计为成功。开头的 75.01% 指达到这一门槛的样本比例。单体结构则用平均 lDDT 衡量局部几何精度。
| FoldBench 任务及指标 | AtomLM-9b | AlphaFold 3 |
|---|---|---|
| 蛋白质单体 · 平均 lDDT | 0.858 | 0.880 |
| 蛋白质–蛋白质 · 成功率 | 75.01% | 72.93% |
| 蛋白质–配体 · 成功率 | 67.45% | 64.90% |
| 抗体–抗原 · 成功率 | 44.00% | 47.90% |
AlphaFold 3 数值取自 FoldBench 论文补充表 3 的全量评测。两种模型采用各自的推理配置。
在这四项比较中,AtomLM-9b 在蛋白质–蛋白质和蛋白质–配体任务上的成功率更高,AF3 在蛋白质单体和抗体–抗原任务上的数值更高。采样设置也会影响比较:蛋白质–配体任务只生成一个候选时,AtomLM-9b 的成功率为 62.10%;生成 25 个候选并用置信度排序后达到 67.45%,高于 AF3 的公开参考结果 64.90%。
论文与模型